
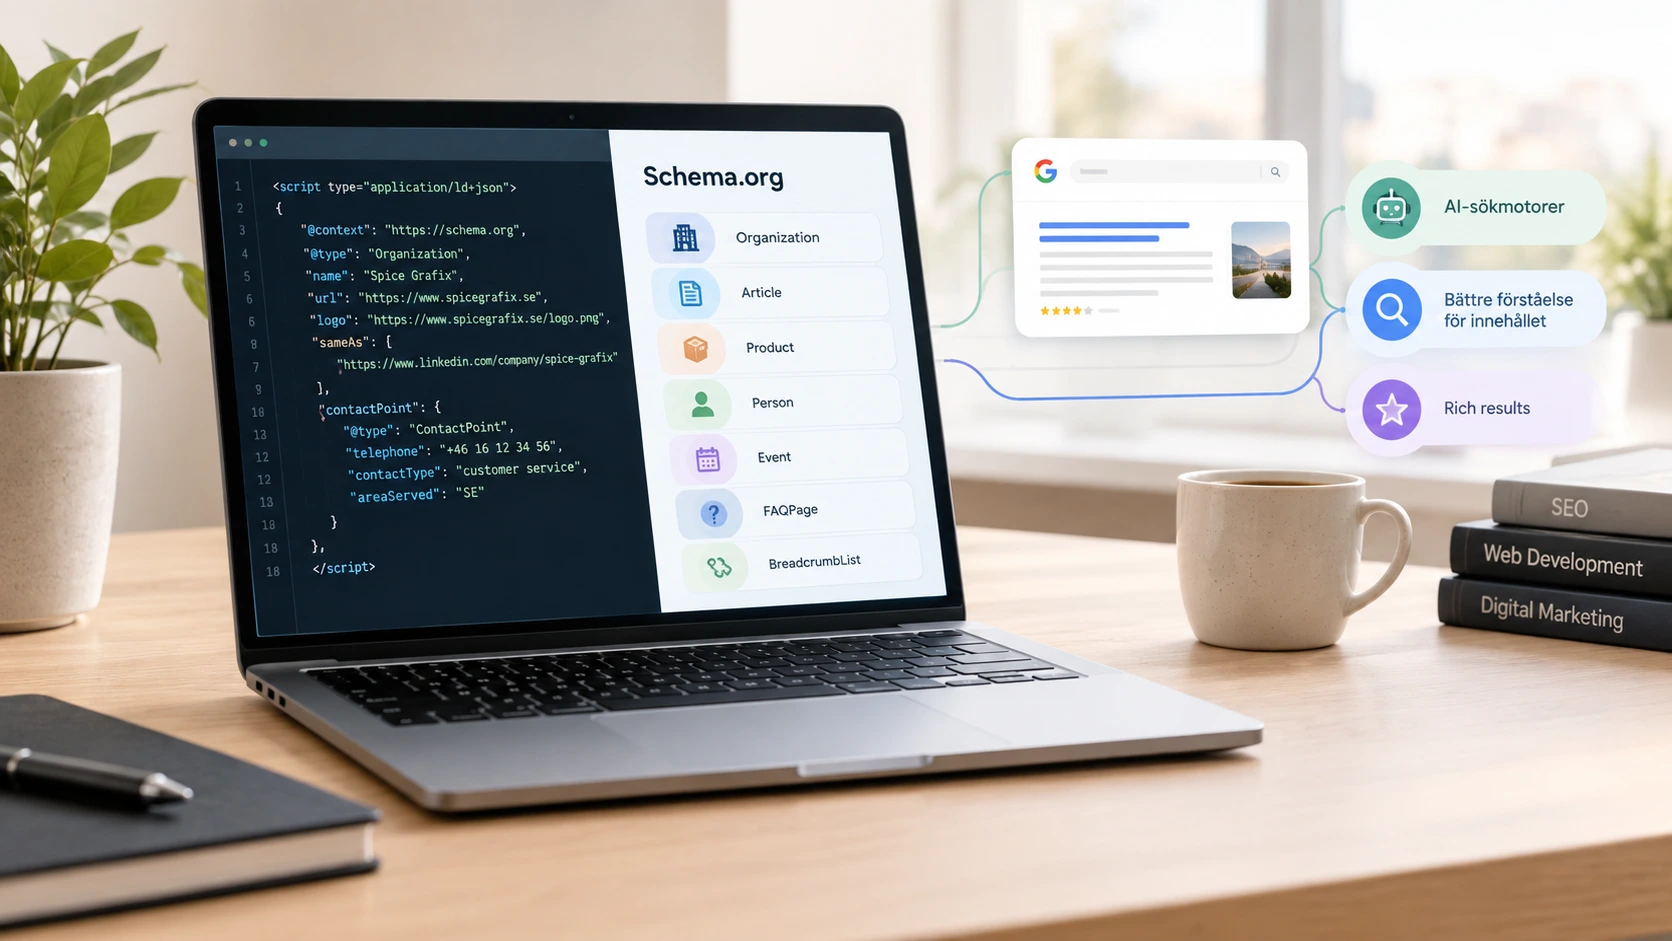
När sökmotorer blir bättre på att förstå innehåll räcker det inte alltid att en sida ser tydlig ut för en människa. Maskiner behöver också kunna tolka vad innehållet faktiskt representerar.
Är det en artikel? Ett företag? En produkt? En person? En tjänst? En FAQ? En organisation med en viss adress och vissa kontaktuppgifter?
Det är här Schema.org och JSON-LD kommer in.
För webbutvecklare och SEO-experter är strukturerad data därför mer än ytterligare en teknisk SEO-detalj. Rätt implementerad kan den skapa ett tydligare maskinläsbart lager ovanpå webbplatsens vanliga innehåll.
Men det finns en viktig missuppfattning att reda ut direkt: strukturerad data är ingen genväg till bättre ranking och det finns ingen garanti för att en sökmotor visar ett rich result bara för att markupen finns på sidan.
Google beskriver strukturerad data som ett sätt att hjälpa sökmotorn förstå innehållet på en sida och vilka entiteter och egenskaper den representerar.
Snabb sammanfattning
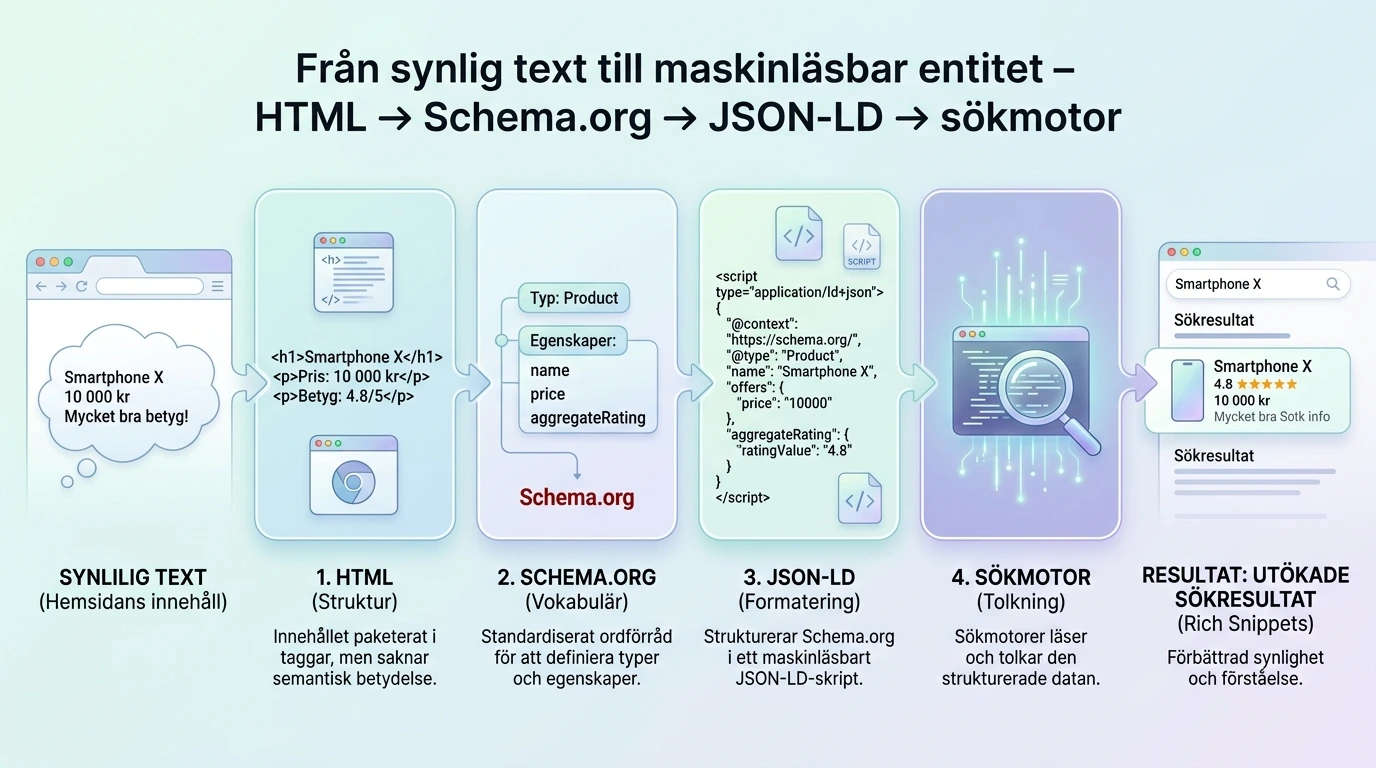
- Schema.org är vokabulären som beskriver vad information på en webbsida betyder.
- JSON-LD är ett format som används för att implementera strukturerad data.
- Strukturerad data kan hjälpa sökmotorer och andra system att tolka innehållet mer exakt.
- Markupen ska beskriva innehåll som faktiskt finns på sidan – inte information som bara läggs dit för SEO.
Article,Organization,Product,BreadcrumbListoch andra typer används beroende på sidans faktiska innehåll.- Validering är en central del av implementationen. Felaktig eller missvisande markup kan skapa problem snarare än förbättra förståelsen.
Vad är Schema.org egentligen?
Schema.org är ett gemensamt vokabulär för strukturerad information på webben.
Tänk på det som ett gemensamt språk mellan webbplatser och maskiner.
Om en webbsida innehåller texten:
Spicegrafix är en webbyrå i Eskilstuna.
kan en människa förstå vad meningen betyder.
Men en maskin måste tolka relationerna mellan informationen. Är Spicegrafix ett företag? Vilken typ? Var ligger det? Vilken webbadress tillhör företaget?
Schema.org tillhandahåller typer och egenskaper som kan användas för att uttrycka sådana relationer.
Exempelvis kan Organization, LocalBusiness, Person, Article och Product representera olika typer av entiteter.
Schema.org kan användas tillsammans med flera format, bland annat Microdata, RDFa och JSON-LD.
Det är viktigt att skilja på vokabulär och format:
| Begrepp | Funktion |
|---|---|
| Schema.org | Beskriver vad informationen betyder |
| JSON-LD | Beskriver hur informationen uttrycks |
| HTML | Presenterar sidans synliga innehåll |
| Strukturerad data | Samlingsbegreppet för maskinläsbar information |
Det innebär att Schema.org och JSON-LD inte egentligen konkurrerar med varandra. De används tillsammans.
Varför används JSON-LD?
JSON-LD står för JavaScript Object Notation for Linked Data.
I praktiken innebär det att strukturerad information kan placeras i ett <script>-element utan att behöva blanda in markupen i sidans synliga HTML.
Ett enkelt exempel kan se ut så här:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Så fungerar strukturerad data",
  "author": {
    "@type": "Person",
    "name": "Anna Andersson"
  }
}
</script>
Det syns inte som vanlig text på sidan.
I stället får sökmotorer ett maskinläsbart lager som beskriver sidan.
Google rekommenderar strukturerad data där den är relevant och stöder JSON-LD som ett av formaten för strukturerad data. Bing stöder också Schema.org i JSON-LD-format.
Ett praktiskt exempel
Föreställ dig en webbplats för en lokal redovisningsbyrå.
På sidan står:
EkonomiPartner hjälper småföretag med bokföring, löner och ekonomisk rådgivning i Eskilstuna.
Det synliga innehållet är fortfarande det viktigaste.
Med strukturerad data kan utvecklaren dessutom beskriva företaget som en organisation och ange relevanta egenskaper som namn, URL, kontaktuppgifter och geografisk information.
Det skapar en tydligare semantisk modell av sidan.
Schema.org är inte samma sak som SEO-magi
Det är lätt att hamna fel här.
Schema.org är inte en rankingfaktor som automatiskt flyttar en sida från plats 20 till plats 1.
Google är tydliga med att strukturerad data kan hjälpa sökmotorn att förstå innehållet, men att det inte finns någon garanti för att en sökfunktion eller ett rich result visas.
Det betyder att du inte bör tänka:
”Hur mycket Schema.org kan jag trycka in på sidan?”
Tänk hellre:
”Vilken information behöver en maskin förstå för att korrekt tolka den här sidan?”
Det perspektivet leder nästan alltid till bättre implementationer.
Steg 1: Identifiera sidans huvudentitet
Börja inte med JSON-LD-koden.
Börja med själva sidan.
Fråga:
- Vad handlar sidan om?
- Vilken är den huvudsakliga entiteten?
- Vilken typ av innehåll är detta?
- Vilka relationer är viktiga?
- Vilken information finns faktiskt på sidan?
- För en bloggartikel kan huvudentiteten vara
ArticleellerBlogPosting. - För en produktsida kan den vara
Product. - För ett företags hemsida kan
Organizationeller en mer specifik undertyp vara relevant. - För en lokal verksamhet kan en lämplig
LocalBusiness-typ vara aktuell.
Google rekommenderar att använda den mest specifika Schema.org-undertyp som passar verksamheten när sådan finns.
Steg 2: Välj rätt Schema.org-typ
Här gör många implementationer det onödigt komplicerat.
Du behöver inte använda alla typer som verkar relevanta.
Välj de typer som faktiskt beskriver sidans innehåll.
| Sidtyp | Exempel på Schema.org-typ |
|---|---|
| Bloggartikel | Article / BlogPosting |
| Företag | Organization |
| Lokal verksamhet | LocalBusiness eller relevant undertyp |
| Produkt | Product |
| Personprofil | Person |
| FAQ-innehåll | FAQPage där användningsfallet och aktuell sökmotorfunktion stöder det |
| Brödsmulor | BreadcrumbList |
| Evenemang | Event |
Det betyder inte att varje sida måste ha en av dessa typer.
Schema.org har ett stort vokabulär, men mer markup är inte automatiskt bättre markup.
Steg 3: Lägg till relevanta egenskaper
När typen är vald är nästa steg att identifiera egenskaper.
För en artikel kan exempelvis följande vara relevanta:
headlinedescriptionimageauthordatePublisheddateModifiedmainEntityOfPage
Google anger bland annat author, headline, image, datePublished och dateModified som relevanta egenskaper för Article-markup.
Men här kommer en viktig utvecklarregel:
Använd inte egenskaper bara för att de existerar.
Använd dem när de representerar verklig information.
Mini-scenario: en artikel på en WordPress-webbplats
En SEO-konsult upptäcker att ett plugin automatiskt genererar Article-markup men saknar information om författaren.
I stället för att skapa en generisk Person-entitet med påhittad information bör konsulten först säkerställa att webbplatsen faktiskt har en författarprofil och att uppgifterna är korrekta.
Strukturerad data ska beskriva verkligheten – inte skapa en önskad version av den.
Steg 4: Koppla ihop entiteter med @id
När webbplatsen blir mer komplex blir @id särskilt intressant.
Anta att en webbplats innehåller:
- en organisation
- flera författare
- artiklar
- tjänster
- produkter
I stället för att beskriva samma entitet på olika sätt överallt kan du använda stabila identifierare för att skapa relationer mellan entiteterna.
Ett förenklat exempel:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "@id": "https://example.se/artikel/#article",
  "author": {
    "@id": "https://example.se/om/#author"
  }
}
Detta blir särskilt användbart när webbplatsen har ett större semantiskt ekosystem.
För en SEO-expert är det också ett bra sätt att börja tänka bortom enskilda sökord och i stället fokusera på entiteter, relationer och sammanhang.
Steg 5: Strukturera JSON-LD som ett sammanhängande informationslager
När flera typer hör ihop kan @graph användas för att beskriva flera relaterade entiteter i samma JSON-LD-block.
Exempelvis kan en sida beskriva:
- organisationen
- webbplatsen
- artikeln
- författaren
som separata men relaterade objekt.
Det kan se ut ungefär så här:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://example.se/#organization",
      "name": "Exempelföretaget"
    },
    {
      "@type": "Article",
      "@id": "https://example.se/artikel/#article",
      "headline": "Exempel på artikel",
      "publisher": {
        "@id": "https://example.se/#organization"
      }
    }
  ]
}
För större webbplatser kan ett sådant tänkande göra strukturen betydligt mer konsekvent.
Det är också här Schema.org blir intressant ur ett GEO-perspektiv.
Schema.org och AI-sökmotorer
AI-sökmotorer arbetar inte exakt på samma sätt som traditionella sökresultat.
De kan behöva kombinera information från flera källor, förstå entiteter och relationer och avgöra vilken information som är relevant för en fråga.
För en djupare genomgång av hur AI-sökmotorer arbetar med information kan du läsa mer om hur AI-sökmotorer tolkar information.
Det vore därför lockande att säga att Schema.org är ”det AI-sökmotorer älskar”.
Men det är mer korrekt att säga att strukturerad data kan bidra med tydligare maskinläsbar kontext.
Det är en viktig skillnad.
Strukturerad data är dock bara en del av den tekniska helheten. Även semantisk HTML för SEO, AI och tillgänglighet hjälper maskiner att förstå hur informationen på en sida är organiserad.
Det finns inte någon generell Schema.org-implementation som garanterar att en AI-tjänst citerar eller rekommenderar en webbplats.
Därför bör teknisk struktur ses som en del av en större helhet tillsammans med:
- semantisk HTML
- tydlig informationsarkitektur
- kvalitativt innehåll
- interna länkar
- entitetsförståelse
- trovärdiga författarsignaler
- teknisk tillgänglighet
- crawlbarhet
Det knyter också an till semantisk HTML, där HTML-strukturen hjälper maskiner att förstå relationen mellan exempelvis rubriker, sektioner, navigation och innehåll.
Steg 6: Anpassa markupen efter sidtypen
En vanlig missuppfattning är att samma Schema.org-struktur ska användas överallt.
Det bör den inte.
En produktsida behöver andra uppgifter än en artikel.
En organisation behöver andra uppgifter än en FAQ.
En webbplats med WooCommerce kan exempelvis ha produktdata som pris, tillgänglighet, identifierare och erbjudandeinformation där detta faktiskt finns.
Google har särskilda riktlinjer för bland annat Product-, Article-, Organization- och andra strukturerade datatyper.
Mini-scenario: WooCommerce
En webbutvecklare bygger en WooCommerce-butik och upptäcker att ett plugin redan genererar Product-markup.
Det är frestande att lägga till ytterligare ett JSON-LD-block manuellt.
Men först bör utvecklaren kontrollera vad som redan genereras.
Två konkurrerande implementationer kan skapa onödig komplexitet och i värsta fall motstridiga uppgifter.
Inventera först. Lägg till sedan.
Steg 7: Kontrollera att markupen stämmer med sidan
Detta är en av de viktigaste principerna.
Google kräver att strukturerad data följer deras riktlinjer och att markupen representerar sidans faktiska innehåll.
Det innebär bland annat att du inte bör:
- ange ett pris som inte visas på sidan
- skapa recensioner som inte finns
- ange felaktiga författare
- beskriva en sida som produkt när den egentligen är en kategorisida
- lägga till egenskaper som inte har stöd i det faktiska innehållet
Strukturerad data är alltså inte en plats där SEO-teamet kan skriva önskelistan.
Den ska spegla webbplatsens verklighet.
Steg 8: Validera innan publicering
När JSON-LD är implementerad är arbetet inte färdigt.
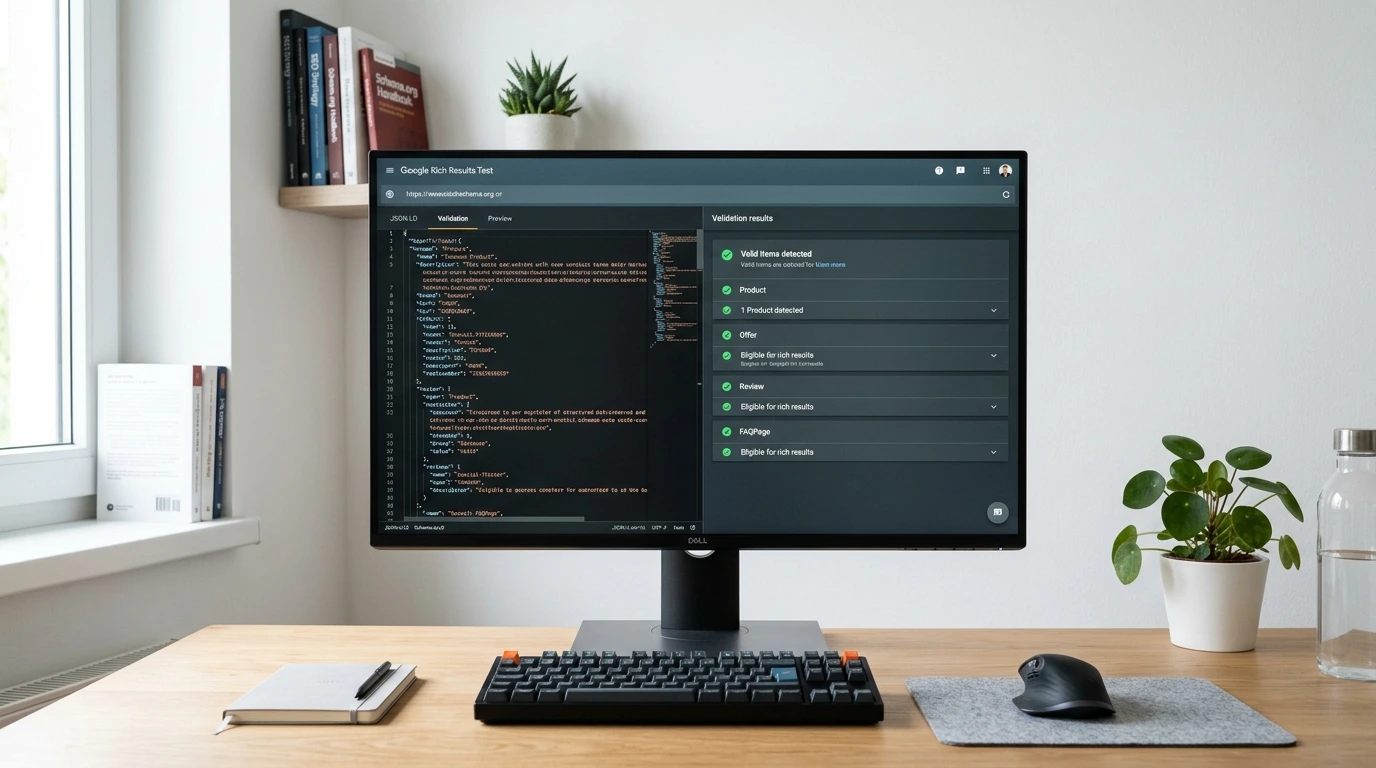
Google rekommenderar att strukturerad data valideras och att fel åtgärdas innan implementationen rullas ut bredare. Google rekommenderar bland annat Rich Results Test och URL Inspection för att kontrollera hur sidan kan tolkas.
En praktisk arbetsgång är:
- Implementera markup på en test- eller begränsad uppsättning sidor.
- Kontrollera JSON-LD-syntaxen.
- Testa sidan med Googles Rich Results Test.
- Kontrollera sidan i Search Console.
- Kontrollera att markupen motsvarar det synliga innehållet.
- Kontrollera canonical, indexerbarhet och crawlbarhet.
- Rulla ut förändringen bredare.
- Följ upp efter att sökmotorn hunnit crawla och bearbeta sidorna.
Det sista steget är lätt att glömma.
En teknisk förändring syns inte alltid omedelbart i sökresultaten.
Vanliga Schema.org-misstag
1. För mycket markup
Att markera allt som går att markera gör inte automatiskt webbplatsen bättre.
Fokusera på relevanta entiteter och egenskaper.
2. Markup som inte motsvarar innehållet
Det här är betydligt allvarligare än att sakna en valfri egenskap.
Om JSON-LD säger en sak och sidan visar en annan skapas en semantisk konflikt.
3. Dubbla implementationer
WordPress, SEO-plugins, e-handelsplugins och teman kan alla generera strukturerad data.
Kontrollera därför alltid vad som redan finns innan du lägger till egen kod.
4. Schema.org som rankinggenväg
Strukturerad data kan hjälpa sökmotorer att förstå innehåll, men den ersätter inte bra innehåll, teknisk SEO eller en fungerande webbplats.
5. Ingen uppföljning
Markup kan bli fel när webbplatsen förändras.
En produkt kan tas bort. En författare kan byta namn. En URL kan ändras. Ett plugin kan börja generera en annan struktur.
Schema.org behöver därför behandlas som en del av webbplatsens tekniska förvaltning.
Schema.org som en del av GEO-strategin
Om du arbetar med SEO och GEO bör Schema.org inte behandlas som en isolerad teknisk åtgärd.
Det är snarare ett av flera lager som hjälper en webbplats att bli tydligare för maskiner. För en bredare genomgång av den tekniska grunden för att strukturera data för AI finns en separat del i serien Från SEO till GEO.
Det passar därför naturligt ihop med en bredare innehållsstrategi för GEO, där målet inte bara är att optimera för traditionella sökresultat utan att göra webbplatsens information tydlig, relevant och användbar i en sökmiljö där AI spelar en större roll.
Det viktiga är dock att inte blanda ihop teknik med innehåll.
En perfekt JSON-LD-struktur kan inte rädda en sida som saknar tydlig information, men en tydlig sida med bra innehåll, semantisk HTML och korrekt strukturerad data ger maskiner betydligt bättre förutsättningar att förstå vad de faktiskt tittar på.
En praktisk checklista för webbutvecklare och SEO-experter
Innan du publicerar Schema.org-markup på en webbplats, kontrollera:
- Har du identifierat sidans huvudentitet?
- Har du valt rätt Schema.org-typ?
- Använder du relevanta egenskaper?
- Stämmer informationen med det synliga innehållet?
- Finns det redan JSON-LD från WordPress, temat eller plugins?
- Undviker du dubbla eller motstridiga entiteter?
- Är
@idkonsekvent där det behövs? - Är organisation, författare och andra centrala entiteter tydligt identifierade?
- Är markupen validerad?
- Är sidan crawlbar och indexerbar?
- Har du dokumenterat implementationen så att den kan underhållas senare?
Slutsats: Strukturera för förståelse, inte för manipulation
Schema.org och JSON-LD är som mest användbara när de används för att göra en webbplats semantiskt tydligare.
- För webbutvecklaren handlar det om att skapa ett strukturerat informationslager.
- För SEO-experten handlar det om att hjälpa sökmotorer förstå innehåll, entiteter och relationer.
- För GEO handlar det om att göra webbplatsens information så tydlig och konsekvent som möjligt i en sökmiljö där maskiner spelar en allt större roll.
Men principen är enkel:
Strukturerad data ska beskriva verkligheten – inte försöka lura sökmotorn att verkligheten är något annat.
Börja därför med innehållet, identifiera entiteterna, välj rätt Schema.org-typer och bygg JSON-LD utifrån den faktiska sidan.
Det är betydligt mer hållbart än att jaga nästa schema-trick.
Gör strukturerad data till en del av din tekniska SEO
Har du en WordPress-, WooCommerce- eller annan webbplats där strukturerad data har vuxit fram genom flera plugins och olika implementationer kan det vara värt att göra en teknisk genomgång.
Kartlägg vad som redan finns, identifiera eventuella konflikter och bygg sedan en konsekvent struktur som både människor och maskiner kan förstå.
Det är den typen av tekniskt SEO-arbete som blir allt viktigare när sök förändras från länkar och nyckelord till entiteter, sammanhang och AI-genererade svar.


Lämna en Kommentar